Autor

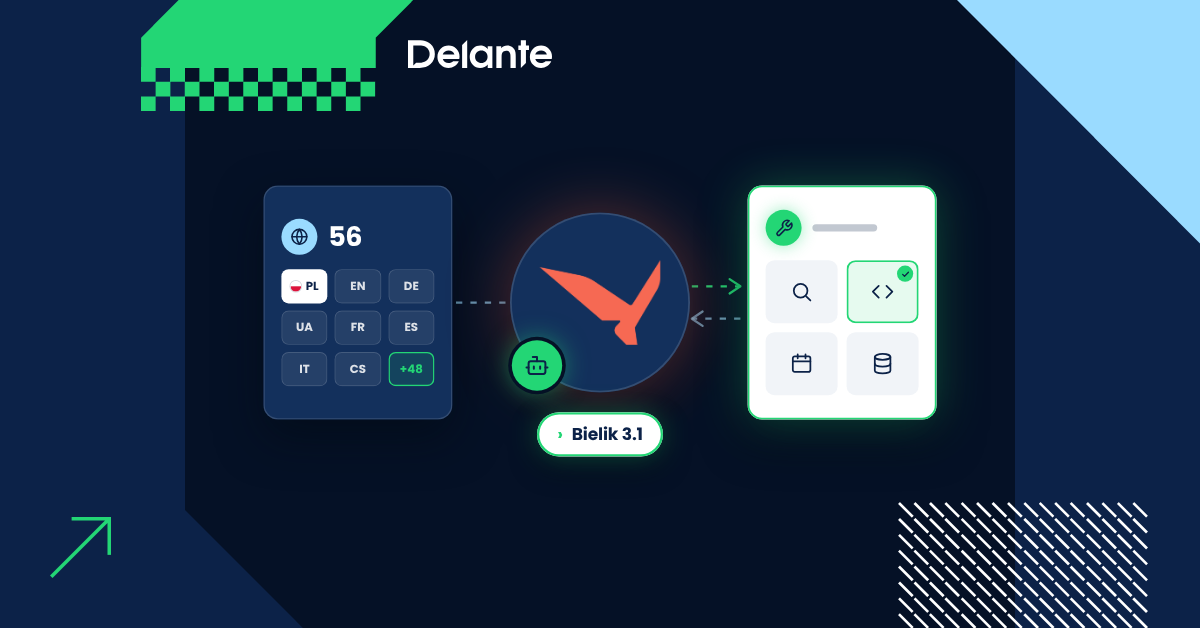
Fundacja SpeakLeash i ACK Cyfronet AGH udostępniły 10 listopada 2026 roku nową wersję polskiego modelu językowego Bielik 11B v3.1. Model obsługuje 56 języków zamiast dotychczasowych 32, a dzięki funkcji wywoływania zewnętrznych narzędzi, ustrukturyzowanym odpowiedziom i rozumowaniu może realizować wieloetapowe zadania. Twórcy ogłosili również modele Bielik-One przeznaczone do klasyfikacji i podejmowania decyzji oraz Bielik DFlash, który przyspiesza generowanie odpowiedzi. Co dokładnie się zmieniło i jakie możliwości otwiera to przed firmami rozwijającymi systemy AI?
Premiera odbywa się etapami: Bielik 11B v3.1 został udostępniony 10 listopada, Bielik DFlash zaplanowano na 11 listopada, a rodzinę Bielik-One na 12 listopada 2026 roku.
Najważniejszy wniosek: Bielik rozwija się z wielojęzycznego modelu konwersacyjnego w kierunku technologii, którą można wykorzystać jako element systemów wykonujących zadania i współpracujących z zewnętrznymi narzędziami.
Nie oznacza to jednak, że jest gotowym, niezawodnym agentem autonomicznym. Skuteczność całego rozwiązania nadal zależy od integracji, jakości danych, uprawnień i kontroli wykonywanych działań.
10 listopada 2026 roku Fundacja SpeakLeash, rozwijająca projekt Bielik AI, oraz ACK Cyfronet AGH przedstawiły nową wersję modelu.
Bielik powstał jako polski projekt otwartego modelu językowego, w którym duży nacisk położono na jakość obsługi języka polskiego i języków europejskich.
Wersja 3.1 rozszerza ten zakres.
Model obsługuje obecnie 56 języków, w tym języki spoza Europy, i otrzymał rozwiązania wspierające zadania wymagające więcej niż wygenerowania pojedynczej odpowiedzi.
Rozwój modelu oparto na dodatkowym treningu na 500 miliardach tokenów.
Jak wynika z dokumentacji technicznej, proces przygotowania obejmował również dostrajanie do wykonywania instrukcji na 26 milionach przykładów oraz uczenie przez wzmacnianie w 14 środowiskach.
W pracach wykorzystano polską infrastrukturę obliczeniową, w tym superkomputery Athena i Helios oraz zasoby Gaia AI Factory.
To istotny etap w rozwoju modelu, którego zastosowania mogą wykraczać poza generowanie tekstów i odpowiadanie na pytania.
W Bieliku 3.0 liczba obsługiwanych języków wynosiła 32.
Nowa wersja zwiększa ją do 56.
Według SpeakLeash model obsługuje wszystkie języki urzędowe Unii Europejskiej.
Do tego dochodzą m.in.:
Z perspektywy firm działających na wielu rynkach jest to istotna zmiana.
Jeden model może potencjalnie wspierać przetwarzanie treści, klasyfikację dokumentów i ekstrakcję informacji w większej liczbie języków.
Nie musi to jednak oznaczać, że osiąga identyczną jakość działania w każdym z nich.
Twórcy przedstawili wyniki dwóch testów porównujących nową wersję z poprzednią.
| Benchmark | Zmiana względem Bielika 3.0 | Co sprawdza? |
| Belebele | +8 p.p. | Rozumienie tekstu w różnych językach |
| INCLUDE | +5 p.p. | Wiedza i rozumowanie w 44 językach, również w kontekście regionalnym |
Źródło: SpeakLeash, komunikat z 10 listopada 2026 roku.
Wyniki wskazują na poprawę deklarowaną przez twórców modelu.
Nie stanowią jednak dowodu, że Bielik 3.1 jest równie skuteczny w każdym języku ani że przewyższa wszystkie konkurencyjne modele.
Dla zastosowań biznesowych konieczne pozostają testy na rzeczywistych danych.
Przykładowo model może poprawnie rozumieć ogólny tekst w języku niemieckim, ale popełniać błędy podczas ekstrakcji specjalistycznych parametrów technicznych.
Dlatego przy planowaniu wdrożenia warto oddzielnie oceniać jakość odpowiedzi dla poszczególnych języków i typów zadań.
Najciekawszym elementem premiery nie jest jednak sama wielojęzyczność.
Nowy Bielik został rozwinięty tak, aby lepiej radził sobie z zadaniami wymagającymi korzystania z zewnętrznych narzędzi.
W praktyce oznacza to połączenie trzech mechanizmów.
Model może przygotować wywołanie określonej funkcji lub narzędzia dostępnego w danym systemie.
Przykładowo agent może otrzymać zadanie sprawdzenia dostępności produktu.
Zamiast samodzielnie wymyślać stan magazynowy, powinien skorzystać z odpowiedniej funkcji pobierającej dane ze sklepu.
Należy jednak podkreślić, że sam model nie uzyskuje automatycznie dostępu do systemów zewnętrznych.
To aplikacja musi udostępnić narzędzia i kontrolować sposób wykonywania operacji.
Bielik może zwracać informacje w uporządkowanej strukturze, np. jako dane JSON.
Jest to przydatne, kiedy odpowiedź ma zostać przetworzona automatycznie, a nie jedynie przeczytana przez użytkownika.
Przykładem może być analiza karty produktu i zwrócenie informacji o cenie, dostępności, kategorii i wykrytych błędach.
W zastosowaniach produkcyjnych wynik nadal wymaga walidacji. Model może wygenerować nieprawidłową wartość lub strukturę, dlatego nie należy zakładać, że każda odpowiedź będzie zgodna z wymaganym schematem.
Bielik 3.1 wykorzystuje tryb rozumowania także podczas pracy z narzędziami.
Ma to pomagać w zadaniach, w których trzeba zaplanować sekwencję działań, wybrać odpowiednie funkcje i uwzględnić wyniki wcześniejszych operacji.
Przykładowy proces może wyglądać następująco:
Takie scenariusze są zbliżone do sposobu działania systemów agentowych.
Jednocześnie trzeba pamiętać, że możliwość wywoływania narzędzi nie jest równoznaczna z niezawodną autonomią.
Agent może błędnie dobrać funkcję, niewłaściwie zinterpretować wynik lub wykonać niepoprawną sekwencję działań.
Dlatego zastosowania produkcyjne wymagają kontroli uprawnień, walidacji oraz odpowiednich mechanizmów bezpieczeństwa.
Twórcy modelu przedstawili również wyniki benchmarku τ²-bench.
To test sprawdzający zdolność modeli do realizowania zadań wymagających interakcji z narzędziami.
Przykładowe scenariusze dotyczą obsługi klienta w takich branżach jak handel, telekomunikacja czy transport lotniczy.
Model musi nie tylko udzielić poprawnej odpowiedzi, ale także wykonać odpowiednie operacje zgodnie z obowiązującymi zasadami.
Według SpeakLeash Bielik 3.1 osiągnął wyniki o 16–45 punktów procentowych wyższe od Bielika 3.0, zależnie od scenariusza.
To istotna poprawa w zadaniach agentowych, ale prezentowane dane wymagają właściwej interpretacji.
Przede wszystkim:
W przypadku wdrożeń biznesowych warto przeprowadzić własne testy, obejmujące również błędne dane, niedostępne narzędzia i niejednoznaczne instrukcje.
W ramach listopadowej premiery SpeakLeash zaprezentował również rodzinę Bielik-One.
To cztery modele zaprojektowane do zadań decyzyjnych.
W przeciwieństwie do klasycznych modeli generatywnych nie koncentrują się na tworzeniu rozbudowanych wypowiedzi.
Ich zadaniem jest przypisanie danych do kategorii lub ocena według określonych kryteriów.
Przykładowe zastosowania obejmują:
Przykładowo system może przeanalizować zgłoszenie klienta i wskazać prawdopodobieństwo, że dotyczy ono reklamacji, problemu technicznego albo pytania o zamówienie.
Na podstawie tych wartości aplikacja może zdecydować, czy zgłoszenie zostanie przekazane do właściwego działu automatycznie, czy wymaga dodatkowej weryfikacji.
Nie oznacza to jednak, że Bielik-One samodzielnie podejmuje dowolne decyzje biznesowe.
Zakres kategorii, progi pewności i sposób obsługi wyników powinny zostać określone przez twórców danego systemu.
Drugim rozwiązaniem ogłoszonym wraz z Bielikiem 3.1 jest Bielik 11B v3.1 DFlash.
To model pomocniczy wykorzystujący technikę speculative decoding.
W uproszczeniu polega ona na tym, że mniejszy model proponuje kolejne fragmenty odpowiedzi, a model główny weryfikuje je przed zaakceptowaniem.
Dzięki temu generowanie tekstu może przebiegać szybciej.
Z perspektywy biznesowej ma to znaczenie zwłaszcza w zastosowaniach, w których liczy się czas odpowiedzi.
Może dotyczyć chatbotów, automatycznej analizy dokumentów lub systemów agentowych wykonujących wiele kolejnych operacji.
Nie należy jednak zakładać określonego wzrostu szybkości bez testów.
Rzeczywiste korzyści będą zależeć od sprzętu, konfiguracji i charakterystyki zadania.
Tak. Model Bielik-11B-v3.1-Instruct jest udostępniony na licencji Apache 2.0.
Pozwala ona na wykorzystanie modelu w projektach komercyjnych, pod warunkiem przestrzegania jej wymagań.
Model udostępniono na platformie Hugging Face:
Bielik-11B-v3.1-Instruct – Hugging Face.
Użytkownicy mogą również zapoznać się z projektem poprzez chat.bielik.ai.
Udostępnienie modelu na otwartej licencji nie oznacza jednak braku kosztów.
Firma wdrażająca rozwiązanie musi uwzględnić m.in. infrastrukturę obliczeniową, utrzymanie, monitoring, bezpieczeństwo i integrację z systemami wewnętrznymi.
W dokumentacji wskazano również ograniczenia dotyczące generowania nieprawdziwych informacji i braku wbudowanych mechanizmów moderacji.
Przed wdrożeniem modelu do obsługi danych klientów czy wykonywania operacji biznesowych konieczne jest więc przeprowadzenie testów jakości i bezpieczeństwa.
Premiera Bielika 3.1 jest interesująca przede wszystkim z perspektywy firm, które chcą wykorzystywać modele językowe do przetwarzania danych i automatyzacji.
Dotychczas wiele takich zastosowań opierało się na dużych modelach dostarczanych przez zewnętrznych operatorów.
Rozwój otwartych modeli może zwiększać liczbę dostępnych rozwiązań, w tym modeli uruchamianych na infrastrukturze kontrolowanej przez firmę.
Nie oznacza to automatycznej przewagi pod względem jakości lub kosztów.
Każde zastosowanie wymaga osobnej oceny.
Obsługa 56 języków może być przydatna w firmach działających międzynarodowo.
Przykładowe zadania obejmują analizę dokumentów, ekstrakcję danych i kategoryzację treści z różnych rynków.
Dla zespołów SEO może to oznaczać możliwość analizowania struktur stron, opisów produktów lub informacji konkurencyjnych w wielu językach.
Warunkiem jest jednak sprawdzenie jakości wyników dla języków wykorzystywanych w danym projekcie.
Modele Bielik-One mogą być interesujące w zadaniach wymagających przypisywania wyników do kategorii.
Przykładowo system audytowy może wykrywać błędy techniczne, a model klasyfikacyjny pomagać w określaniu ich typu lub priorytetu.
W takim scenariuszu należy sprawdzić, czy model rzeczywiście poprawia skuteczność klasyfikacji względem istniejących reguł i innych dostępnych modeli.
Dzięki function calling i reasoning Bielik 3.1 może być testowany jako element agentów korzystających z narzędzi.
Przykładowo agent mógłby pobierać informacje, wykonywać kontrolowane analizy, porównywać wyniki i przygotowywać raport.
To szczególnie interesujące w systemach łączących modele językowe z bazami danych, API i wewnętrznymi aplikacjami.
Z perspektywy sklepów internetowych możliwości agentowe są istotne m.in. przy analizie danych produktowych, kontroli spójności informacji i automatyzacji powtarzalnych procesów.
To obszar powiązany z rozwojem Agentic Commerce.
Warto jednak rozróżnić dwa zastosowania.
Bielik 3.1 może być wykorzystywany do budowy narzędzi analizujących lub przetwarzających informacje o produktach.
Nie oznacza to, że sklepy korzystające z Bielika automatycznie stają się gotowe na zakupy realizowane przez zewnętrznych agentów AI.
Taka gotowość wymaga m.in. odpowiedniej infrastruktury, dostępnych danych produktowych oraz bezpiecznych mechanizmów integracji.
Rozwój modeli zdolnych do korzystania z narzędzi zwiększa znaczenie technicznej dostępności informacji w internecie.
Agent wykonujący zadanie zakupowe musi poprawnie odczytać dane, zrozumieć warunki oferty i – jeśli posiada odpowiednie uprawnienia – wykonać określone działania.
Nie wystarczy więc jedynie dobra widoczność produktu w wyszukiwarce.
Istotna staje się również jakość danych i możliwości komunikacji między systemami.
W raporcie Delante dotyczącym gotowości 15 polskich sklepów RTV/AGD i elektroniki średni wynik autorskiego Agentic Commerce Score wyniósł 32,7/100.
Analiza obejmowała m.in. strukturę informacji, dostępność techniczną i wybrane elementy infrastruktury istotne dla systemów AI.
Zobacz raport Delante o gotowości sklepów na Agentic Commerce.
Badanie nie dotyczyło samego Bielika i nie stanowiło testu przeprowadzania autonomicznych zakupów.
Pokazuje jednak obszary, w których sklepy mogą wymagać dalszych prac, jeśli chcą być lepiej przygotowane do współpracy z systemami agentowymi.
Rozwój modeli takich jak Bielik 3.1 może zwiększać zainteresowanie takimi integracjami.
Przed wdrożeniem warto przeprowadzić porównanie z modelami obecnie wykorzystywanymi w organizacji.
Dobry test powinien obejmować nie tylko poprawność odpowiedzi, lecz także czas działania, koszt oraz niezawodność.
| Obszar | Co sprawdzić? |
| Jakość | Poprawność wyników na rzeczywistych danych |
| Wielojęzyczność | Wyniki osobno dla każdego potrzebnego języka |
| Function calling | Poprawny dobór narzędzi i argumentów |
| Zadania wieloetapowe | Odsetek procesów zakończonych sukcesem |
| Structured output | Zgodność odpowiedzi z wymaganym schematem |
| Szybkość | Czas odpowiedzi i przepustowość |
| Koszt | Całkowity koszt uruchomienia i utrzymania |
| Bezpieczeństwo | Kontrola dostępu, walidacja i odporność na błędy |
W szczególności nie należy porównywać modeli wyłącznie na podstawie ogólnych benchmarków.
Model osiągający dobre wyniki w rozumieniu tekstu może być mniej skuteczny w specjalistycznym procesie wymagającym korzystania z kilku narzędzi.
Równie ważne jest sprawdzenie, jak zachowuje się w sytuacjach wyjątkowych: przy brakujących danych, błędach API czy niejednoznacznych poleceniach.
Listopadowa premiera pokazuje, że polski projekt rozwija się w kilku kierunkach jednocześnie.
Bielik 3.1 rozszerza kompetencje językowe i zdolność do współpracy z narzędziami.
Bielik-One koncentruje się na klasyfikacji i ocenie danych, a DFlash ma zwiększać szybkość generowania odpowiedzi.
W kolejnych miesiącach kluczowe będzie jednak nie tylko publikowanie nowych benchmarków, ale również sprawdzanie modeli w rzeczywistych zastosowaniach biznesowych.
Szczególnie interesujące będą niezależne testy jakości, porównania kosztów wdrożenia oraz ocena skuteczności zadań agentowych.
Najważniejsza zmiana nie polega na tym, że Bielik potrafi rozmawiać w 56 językach. Polega na tym, że rozwija możliwości potrzebne do tworzenia systemów AI, które nie tylko odpowiadają, ale również wykonują określone działania.
To otwiera nowe możliwości automatyzacji, ale wymaga odpowiedzialnej integracji, odpowiednich zabezpieczeń i weryfikacji wyników.